一台 12GB 显存的电脑,能装下多少本地 AI:45 天模型侧实录
这是两篇中的第一篇,只讲模型:显存怎么算、27B 怎么救回来、出图出视频、机器人、MoE 为什么比稠密快,以及我在参数上打的三次脸。
机器本身(配置怎么选、系统从老电脑迁移、三块盘分工、内存插法、网络与 Windows 精简的代价)在第二篇《为了跑本地大模型,我把老电脑的系统整台搬了过来》。
全文数字都是本机实测,包括后来被我自己推翻的那几个。
写在前面:起点是闲置,不是慢
去年这个时候,这台机器已经跑了好几天本地大模型。我觉得它慢。
直到有天空闲我瞄了一眼任务管理器——GPU 占用 0%。
不是慢,是根本没在用。当时用的是 CPU 版推理引擎,八核十六线程在那儿硬算,而一块 RTX 3060 12GB 在旁边看热闹。
换上 CUDA 版之后,同一个 4B 模型:
| 指标 | CPU 版 | CUDA 版 | 提升 |
|---|---|---|---|
| 提示处理 pp512 | 87.8 tok/s | 2443 tok/s | 27.8 倍 |
| 生成 tg128 | 11.0 tok/s | 87.9 tok/s | 8.0 倍 |
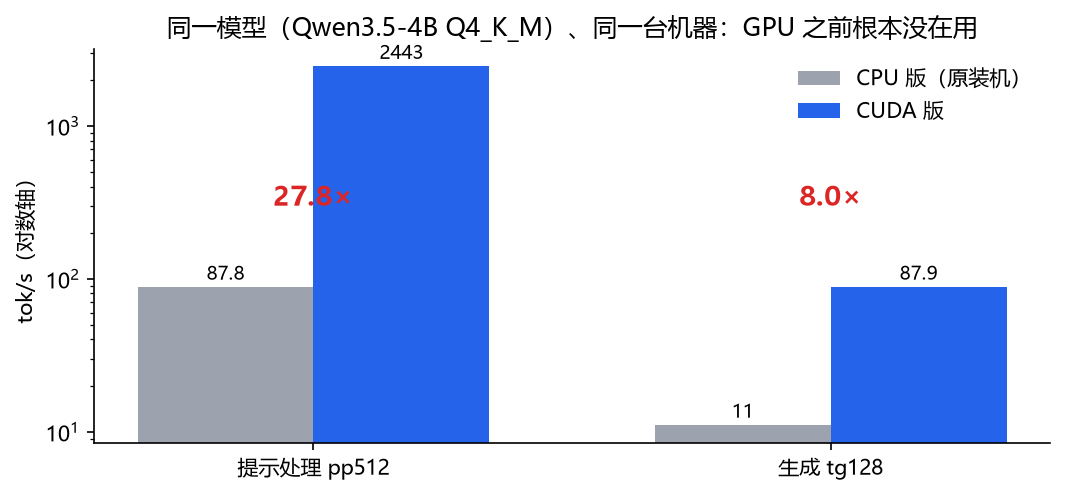
这个坑本身不高级,但它教会我的东西贯穿了后面 45 天:先测,再判断。 我”觉得慢”,但慢不是问题,闲置才是。后面我又犯了三次同样的错,都在最后一节列出来。
顺便一个 Windows 特有的小插曲:装完 CUDA 版,--list-devices 返回空。不是驱动问题,是这个发布包不含 CUDA 运行时,得另外下那个几百 MB 的 cudart 配套包。缺库的时候它不报错,只是安静地告诉你”没有 GPU”。
第一课:12GB 不是”中等显存”,是一道硬墙
有了 GPU 之后,下一步自然是”上个更大的模型”。然后我发现事情不对:27B 量化版跑起来只有 2.9 tok/s。
原因是显存。12GB 听起来不小,但要留给 KV 缓存和计算缓冲,权重文件实际的安全线是 7.5GB。27B 的 Q4 量化是 17.9GB,塞不进去,引擎只能把 64 层里的 35 层放显存、29 层留内存。每生成一个 token 都要跨 PCIe 搬那 29 层,速度直接崩到个位数。
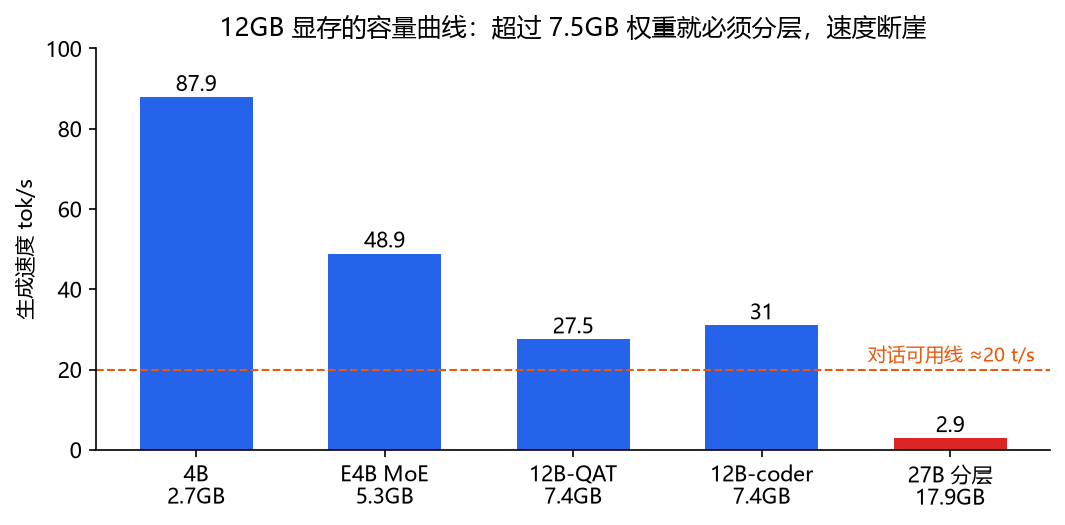
这里有个反直觉的点:分层不是”慢一点”,是断崖。35/64 层留内存,速度不是从 45 掉到 25,是从 45 掉到 2.9。超过总层数 40% 留在 CPU,基本就没救了。
正确的算法是先算账:
1 | 可用显存 = 12288 MiB - 桌面占用(约 500) - KV 缓存 - 计算缓冲 |
而不是”这个模型 16GB,我显存 12GB,那应该能跑个八成速度吧”。不能,跑不了。
llama.cpp 有个 llama-fit-params 工具就是干这个的,你给它模型和上下文长度,它告诉你 -ngl 该填几。有个小坑:别自己传 -ngl,传了它直接 abort,它要自己拟合。
第二课:三元量化把 27B 救了回来,但代价在后面
正当我要放弃 27B 的时候,遇到了三元量化(PQ2_0)——把权重压到 7.66GB。刚好卡进 7.5GB 安全线附近,全 65 层进显存。
速度:2.9 → 34.6 tok/s(还没开投机解码)。
然后投机解码(MTP,模型自带一个小的”猜下一个词”的头)把它推到 45.3 tok/s。
这里踩到一个值得单独说的坑:默认参数不是最优解。MTP 的草稿深度默认是 3,我扫了一遍:
| 草稿深度 | 速度 | 接受率 |
|---|---|---|
| 1 | 4.23 | 66.7% |
| 2 | 5.06 ~ 6.71 | 59~62% |
| 3(默认) | 4.50 ~ 5.50 | 39.7~45.6% |
| 5 | 2.18 | 草稿基本全废 |
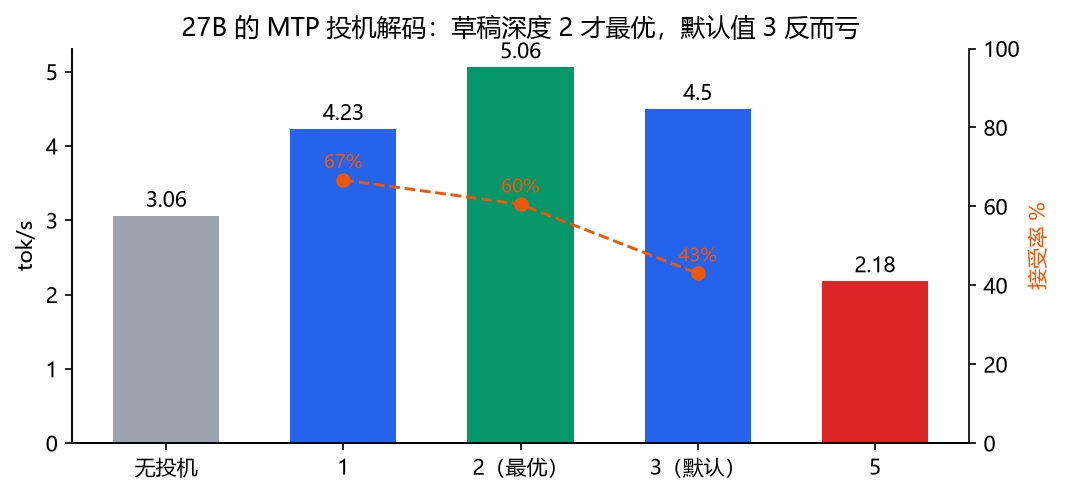
后来在换了三元量化之后又扫了一次,结论一样:2 最优,3 掉到 33 tok/s,4 掉到 24.4。每步净产出的 token 数确实随深度增加,但验证成本涨得更快。 这个”净产出不是目的、每秒 token 才是”的教训,后面又帮了我一次。
三元量化的代价也很实在:这份模型在 MMMU-Pro(75.49 vs 81.73)和 OCR 基准(56.88 vs 60.99)上掉分最狠。所以我没有让它取代视觉档,而是分工:日常和 agent 用它,看图交给专门的小模型。
第三课:上下文长度是用显存换的,而且是线性换
27B 档的上下文我最后定在 98304(96K)。听起来很爽,代价是 KV 缓存精度从 q8_0 降到 q4_0——因为 98304 用 q8_0 装不下。
实测:
| 上下文 | KV 精度 | 显存 | 能否全进显存 |
|---|---|---|---|
| 65536 | f16 | 超 | 否(-ngl 58,7 层落内存) |
| 65536 | q8_0 | 11931 MiB | 是 |
| 98304 | q4_0 | 11796 MiB | 是 |
有个意外收获:q4_0 KV + 98304 上下文,比 q8_0 + 65536 还省 135MB,上下文却多了 50%。
长上下文真正的价值在前缀缓存。我灌了 42585 token 的一份文档测:
| 轮次 | 新增 token | 命中缓存 | 预填耗时 | 端到端 |
|---|---|---|---|---|
| 第一轮(冷) | 42585 | 0 | 108.2 s | 113.6 s |
| 第二轮(追加) | 83 | 42581 | 0.7 s | 4.9 s |
所以 agent 场景下,第一轮慢是必然的,但只要历史只追加不修改,后续每轮几乎免费。这条约束很关键:中段改写旧消息(压缩、删工具结果)会让缓存部分失效,等于重新付 108 秒。
我还试过 --cache-reuse 256 想救这个,结果连完全相同的重复请求都 cached_n=0,前缀缓存被整个打死。已写进”不要再试”清单。
第四课:文生图,32MB 的库打赢了 21GB 的方案
出图这块我一开始走错了方向——准备装 CUDA 版的 sd.cpp,21GB。
结果 Vulkan 版只要 32MB,功能一样,速度还更快(因为省掉了 CUDA 版本的一些兼容开销)。这是我这个月最省的一笔。
真正的大头是提速。原始配置一张 1024×1024 要 362 秒,最后 27 秒。中间被推翻的三个直觉:
① “显存不够要开低显存模式”——反了。 --lowvram / --medvram 这类参数在这台机器上只会增加数据搬运。真正有用的是 --offload-to-cpu(把不常动的组件放内存)和 --diffusion-fa(注意力融合,实测每步 -35%)。
② “出图模糊是模型问题”——是服务端不认 LoRA 标签。 用 4 步的 turbo 加速时,<lora:xxx> 标签被 sd-server 直接忽略,等于没挂 LoRA,出图糊成一片。解法是用已经融合好 LoRA 的 DiT 权重,而不是运行时挂。
③ “宽高随便填”——必须是 64 的倍数。 否则正中间出现一条接缝,非常诡异。我一开始怀疑是模型问题,折腾半天。
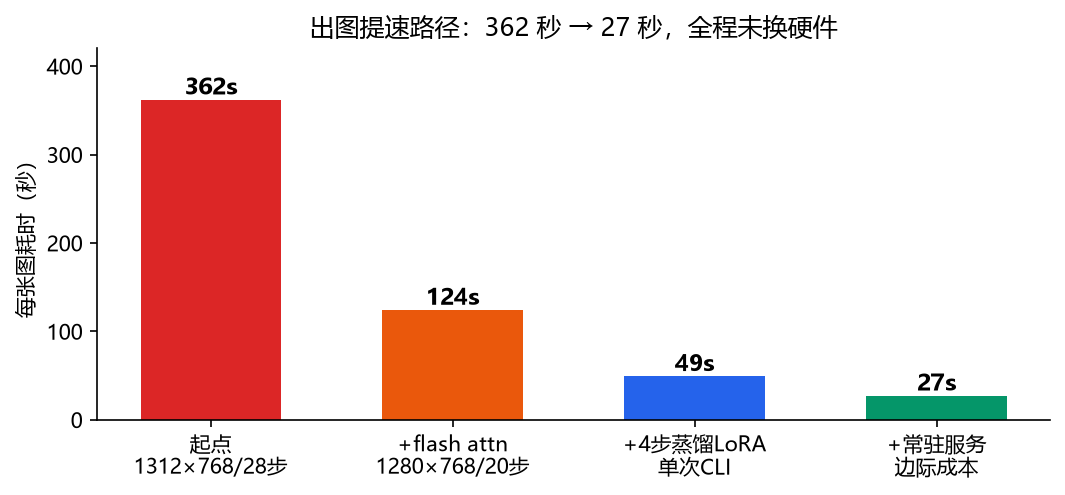
还有一个 --eager-load,官方说能加速,实测把载入时间拖到 107 秒。反直觉,但数据说话。
第五课:图生视频,5B 比 1.3B 快
想加视频能力的时候,我按参数量估算:”5B 模型肯定比 1.3B 慢四倍,先用 1.3B 试试。”
实测结果:
| 模型 | 832×448 / 33 帧 / 20 步 总耗时 |
|---|---|
| Wan2.1 T2V 1.3B | 232 秒 |
| Wan2.2 TI2V 5B | 152 秒 |
大的反而快 34%,画质还明显更好。
原因是 Wan2.2 的 VAE 时空压缩比是 16×16×4,比 2.1 的 8×8×1 少了一大截 latent token。我的”参数多=慢”直觉在扩散模型这里根本不成立,瓶颈在 latent 空间的体积,不在参数量。
坑还有两个:VAE 解码默认 32×32 tile 会直接爆显存(vae decode compute failed while processing a tile),改 16×16 就好;以及 sd.cpp 只能写 AVI,浏览器和微信都打不开,得挂 ffmpeg 转 H.264 + yuv420p + faststart。
顺带一个 Windows 的:转码那一步如果抛异常,会连带跳过”恢复对话模型”的逻辑,导致机器人莫名离线。后来把转码单独包了 try/catch。
第六课:把机器人关进虚拟机
模型能跑了,下一步是让它自己收发消息。我没敢在宿主机上直接跑第三方 agent 框架,于是用 Hyper-V 建了个 Ubuntu 虚拟机,模型服务留在宿主机。
架构是这样:
1 | IM 平台 ←长连接→ 虚拟机里的 agent ←HTTP→ 宿主机模型服务 |
全程零入站端口:虚拟机主动往外连,外面进不来。宿主机给虚拟机开的内部网段也只对虚拟机网卡放行,家用 Wi-Fi 里的其他设备访问不到。
三个花了时间的坑:
- IP 记错,误判任务失败。 虚拟机是
.20,我拿.10去 ping(那是另一台老机器),不通,就报告”迁移失败”。用户一句”你去核实下”才发现是我的探测目标错了。教训:验证要验到具体的端口和会话数,不能只看 ping。 - 优雅关机不能强来。 涉及虚拟机磁盘的操作,我一律先
Stop-VM -ShutDown等最多 6 分钟,超时宁可中止也不硬断电——ext4 脏盘的风险不值得赌。 - 网关是”用户级”systemd 服务。
systemctl is-active <agent网关>会误报 inactive,必须加--user。我因为这个多查了十分钟。
第七课:加了 32GB 内存之后,MoE 改变了格局
后来内存从 32GB 加到 64GB。加之前我先做了体检,因为 MoE 模型吃的不是显存,是内存带宽:
1 | 4×16GB DDR4-2666,A1/A2/B1/B2 全满 |
判据是两个通道的总容量是否相等,跟插了几条、单条多大都没关系。3×16GB 是 32/16 不对称,会掉到对称配置的 60~70% 带宽。这一步要是插错了,后面全白搭。
有了 64GB,MoE 引擎就打开了。这类引擎的思路是:模型 125B 参数,但每生成一个词只激活其中一小部分专家,于是显存放热专家、内存放全部专家、SSD 放查找表。
实测对比(同一台机器):
| 引擎 | 上下文 | decode | 显存 |
|---|---|---|---|
| llama.cpp 27B 稠密 + MTP | 98K | 43.5 tok/s | 11.8 GB |
| MoE 35B-A3B(4-bit) | 64K | 50.4 tok/s | 11.3 GB |
| MoE 125B(IQ3_XXS) | 256K | 62~67 tok/s,峰值 90 | 11.7 GB |
参数量大 4.6 倍的模型,反而比 27B 快一半。 一开始我很难接受这件事,后来算了一笔账就通了:
1 | 稠密 27B:每个 token 必须读完 7.66GB 权重 |
所以我的 27B 不是”没调好”,是架构被判了死刑。这个认知让我停止了对稠密档的继续优化——省下了很多时间。
日志里还有个数据很说明问题:expert cache hit 96.9% (198936/205370)。命中率就是这类模型的命根子,比 tok/s 更能解释”为什么刚才快现在慢”。
第八课:盘位这件事,模型侧只需要记住一条
虚拟机磁盘我搬了三次(E → F → C),完整故事在第二篇里——包括那块 SMR 叠瓦盘的坑、robocopy /E 把虚拟机注册文件覆盖掉、以及 Stop-VM -ShutDown 在这台机器上根本不存在这个参数。
模型侧只需要一条:权重和虚拟机磁盘必须放 SSD/NVMe,机械盘只配当归档。 同样一个模型,从叠瓦机械盘加载和从 NVMe 加载,等待时间差好几倍;放错盘之后你去排查为什么这么慢,方向会全错。
我的最终落点:所有正在使用的模型权重都在 NVMe,程序本体留在机械盘(只在启动时读一次,无所谓)。
第九课:给自己写了个监控看板
看到别人机器上有个漂亮的硬件监控面板(双卡、逐核占用、15 分钟趋势、实时 tok/s),我想复刻一个。
先做的还是调研:GitHub 上找了一圈,最后没装现成的——它们要么依赖 Python 第三方库,要么为 Linux 写(读 /proc、hwmon)。我改用自己写,纯标准库单文件,8770 端口。
搬的过程中踩到的技术点,两个属于 Windows 硬件探测(探测没人监听的端口在 Windows 上不是瞬间失败、GetSystemTimes 给不了逐核数据),细节写在第二篇。这里只留两个跟模型直接相关的:
① CPU 温度这一格显示不了。 Linux 有 hwmon,Windows 得装内核传感器驱动。所以看板上它只能空着,并在页脚写清楚为什么——不知道的就不装懂。
② 加 llama-swap 做旁路看板时学到一招:它的 proxy 模式必须配一个 cmd,否则报 empty command。用一个 ping -n 999999 当占位进程就解决了——它只转发不启动,完全不干扰原有服务。看板因此能同时列出两个引擎,而不需要改动任何一个模型服务的启动方式。
看板最有用的不是好看,是它把”两个引擎的 tok/s 语义不一样”这件事摆到了台面上:MoE 引擎给的是实时速率,而 llama.cpp 只在一次生成结束时才更新计数器——所以请求进行中那一格显示空是正常的。第一次看到时我以为看板坏了,查了十分钟才发现是两边导出指标的机制根本不同。
第十课:我打了自己三次脸
这一节是全文最有价值的部分。
打脸一:-b 4096 提速 7.4% —— 假的
llama-bench 显示 -b 从 2048 到 4096,生成速度 +4.2%。真实服务上又测出 +7.4%。两条”独立证据”同向,我据此改了配置,还写进了文档。
然后用固定随机种子、同一会话内交替 A/B、每组 4 次重测:
1 | -b 4096:43.53 tok/s(sd 0.69) |
没有收益。 那 7.4% 是时段漂移——同一份 -b 2048 配置,早半小时测 40.7,晚半小时测 43.64,绝对值能漂 7%。我的两次”独立证据”共用同一个漂移,所以根本不独立。
打脸二:reasoning_effort 模板不消费 —— 我搜错了
模型卡建议设 reasoning_effort。我 grep 二进制,搜到 0 次,于是写进文档”这个参数在这份文件上是空转的”。
后来把 GGUF 元数据里的 tokenizer.chat_template(8952 字符)完整解析出来看:reasoning_effort 出现 6 次,enable_thinking 4 次,还有白名单校验和抛异常逻辑。
真相是:模板只写了 xhigh 和 low 两条分支,medium 能通过白名单校验但匹配不到任何分支,于是力度指令是空串——“设了没反应”是真的,”变量不被消费”是我的误判。
改成 low 之后实测:轻任务少 24% token、省 25% 时间,三道推理题(含”5 台机器 5 分钟”那个经典陷阱)全对。而 enable_thinking:false 能再快 7~9 倍,但诊断类任务会把第一原因答错——所以它只适合批量改写,不适合 agent。
顺带解释了之前一直出现的 500 Unexpected reasoning effort minimal:模板自己抛的,白名单只有三个值。
打脸三:humanizer-12b 口碑很好 —— 四项全输
一个专门”去 AI 味”的 12B 模型,社区评价很高。第一次测我做得很薄(丢几段中文看改不改,还顺手考了它数学题——那是我用错场景)。
第二次按规矩测:四篇输入(两中两英),每篇埋了必须原样保留的数字和人名,跟现网的 27B 加明确改写指令做同题对比:
| 指标 | humanizer-12b | 27B + 指令 |
|---|---|---|
| 中文套话清除 | 6→2、5→1 | 6→0、5→0 |
| 中文事实存活 | 千分位逗号丢了(48,000→48000) |
全在 |
| 英文套话清除 | 9→3、6→0 | 9→0、6→0 |
| 改动幅度 | 0.32 / 0.90 / 0.85 | 0.45 / 0.91 / 0.86 |
它只是把套话换成另一批套话(It's worth noting→Interestingly、Moreover→Furthermore),骨架没动。唯一优势是端到端快 4~5 倍,但那不是模型的功劳——是 27B 每次吐 591 个 token 里 500 个在思考,把思考调低就能拿到同样时延。
判定:不入库。权重文件删掉了。
三次打脸的共性
我都在”看起来合理”的时候停了手。 27.8 倍、+7.4%、社区好评,都是别人(或工具)给的结论,我没有把它压到一个可复现的测量里。
沉淀下来的几条规矩
- 先量,再改,再复测。 顺序不能反。
- 测速必须锁随机种子,否则测的是采样彩票不是速度。
- 同一会话内交替 A/B,每组至少 4 次,报 mean/sd/min/max,不报单次最好看的数。
- 判”有效”的门槛:差值大于两组标准差,且 ≥3%。本机时段漂移实测 7%,低于这个线的都不算。
- 两条证据要真独立——共用同一个时段漂移的两条测量,是一条。
- 查模型内部的东西要解析元数据取字段,不要在二进制上 grep。
- 反直觉的参数默认怀疑:
--eager-load(拖慢载入)、--cache-reuse(打死前缀缓存)、-ub 1024(挤掉 CUDA graph)、--lowvram(增加搬运),全都”看起来该有用”。 - 验证要验到端口和会话数,一个 ping 不通可能是你 ping 错了机器。
- 给每个证伪的结论建一张表,否则三个月后自己会再试一遍,浪费的还是机器的电和自己的时间。
最终形态
一台 12GB 显存、64GB 内存的机器,现在常驻这些东西:
| 服务 | 端口 | 说明 |
|---|---|---|
| 主力对话 / agent | 8080 | 27B 三元量化 + MTP,96K 上下文,43.5 tok/s |
| 视觉服务 | 8081 | CPU 推理,零显存,专门给机器人看图 |
| MoE 第二引擎 | 8091 | 35B-A3B,50.4 tok/s,与主力抢显存、二选一 |
| 统一看板 | 8770 | 硬件 + 两个引擎的 tok/s + 15 分钟趋势,纯标准库 |
| 旁路看板 | 9090 | 只转发不接管 |
| 文生图 / 图生视频 | 按需 | Vulkan 版,1024² 27 秒;视频自动转 MP4 |
| 虚拟机 agent | — | 长连接收发消息,零入站端口 |
一个入口脚本管所有档位,双击 .bat 就能切,一个自检菜单覆盖文件完整性、显存、网络、对话、机器人依赖链、看图能力。所有权重和程序都在本地磁盘,断网全功能可用(自检会逐文件核对字节数,18 个文件)。
回头看,最大的收获不是某个参数调对了,而是那三次打脸教会我的:“看起来合理”和”测出来是这样”之间,隔着一次固定种子的配对复测。
一台 12GB 显存的机器能装下这么多东西,靠的不是硬件,是把每一分显存都算清楚了。